
Etiquetado inteligente en la industria
octubre 29, 2026
Campaña Letras de Lucha
octubre 29, 2026La IA descubrió cómo extraer fotografías de un Android bloqueado. ¿Qué tan protegida está nuestra vida digital?
Por Ricardo Bolaños | 28 de octubre de 2026
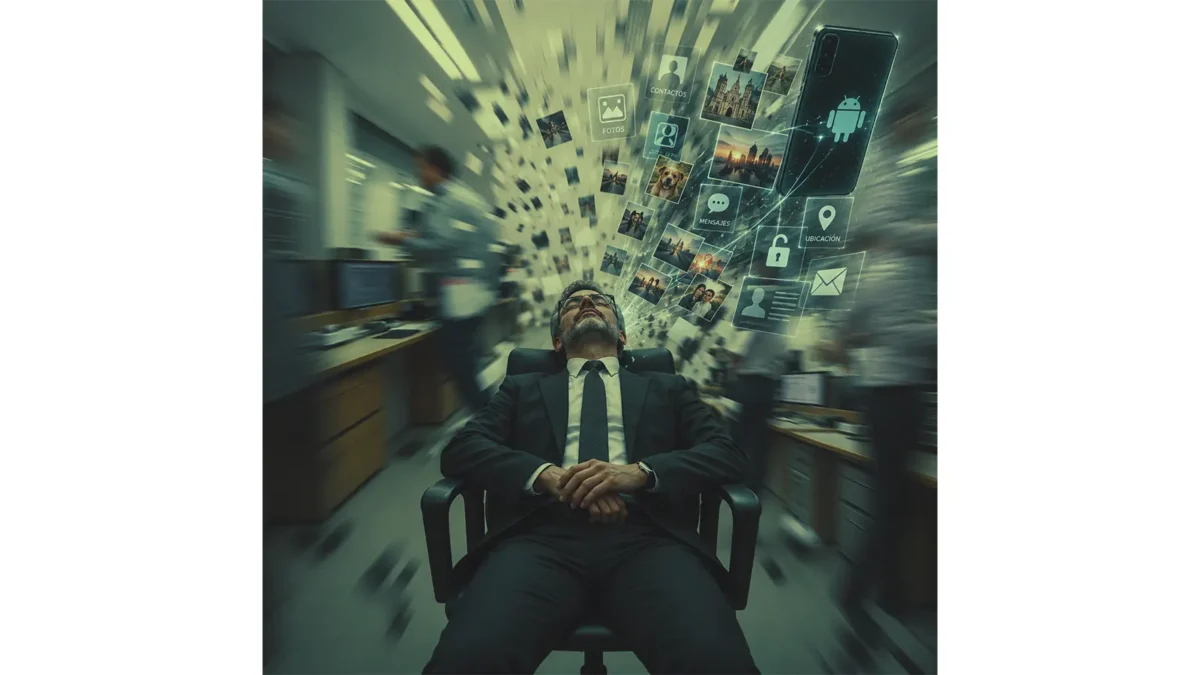
Un teléfono Android permanece bloqueado. Su propietario no ha proporcionado ninguna contraseña, no ha autorizado una transferencia de archivos y tampoco ha desbloqueado la pantalla. Sin embargo, mediante una conexión USB y aprovechando una cadena de vulnerabilidades, es posible extraer fotografías y otros datos personales almacenados en el dispositivo. Este escenario, que hasta hace poco podía parecer parte de una demostración cinematográfica de espionaje tecnológico, fue reproducido en condiciones de laboratorio por investigadores de Anthropic utilizando inteligencia artificial.
El experimento fue realizado sobre un Google Pixel 9, con acceso físico al dispositivo, y sus resultados se hicieron públicos el 27 de octubre de 2026. No existe evidencia presentada en la investigación de que esta técnica se haya utilizado de forma generalizada contra usuarios reales. Google corrigió las vulnerabilidades identificadas. Sin embargo, la relevancia del descubrimiento está en el procedimiento utilizado: un modelo avanzado de IA consiguió analizar componentes de software, identificar distintas debilidades y combinarlas hasta construir una secuencia funcional de explotación.
Durante décadas, encontrar una vulnerabilidad crítica podía exigir meses de investigación especializada, conocimientos profundos de arquitectura de sistemas y una considerable inversión de recursos. Actualmente, los modelos más avanzados comienzan a demostrar capacidades para participar activamente en ese trabajo, automatizando tareas que antes dependían casi por completo de investigadores humanos. La diferencia es importante porque el potencial de estas herramientas puede beneficiar tanto a quienes protegen los sistemas como a quienes eventualmente intenten comprometerlos.
Mi preocupación nace precisamente de este nuevo escenario. Estamos incorporando herramientas de inteligencia artificial a nuestras actividades cotidianas con una velocidad considerable, especialmente aquellas capaces de ejecutar tareas, consultar documentos, utilizar aplicaciones y operar con cierta autonomía. Mientras descubrimos cómo multiplicar nuestra productividad, pocas veces nos detenemos a evaluar qué información estamos poniendo a su alcance y si los equipos donde trabajamos deberían continuar concentrando, sin distinción, nuestra vida privada, financiera y profesional.
Un teléfono bloqueado y cuatro barreras de seguridad superadas
El informe de Anthropic, titulado Discovering and Exploiting Vulnerabilities in Critical, Real-World Software with Claude, describe cómo su equipo de investigación utilizó un modelo experimental de Claude para localizar y encadenar vulnerabilidades en distintos sistemas operativos y navegadores. En el caso de Android, el modelo combinó análisis de código fuente, ingeniería inversa de componentes propietarios y pruebas sobre un dispositivo físico.
La protección de un teléfono bloqueado contempla varias barreras. Entre ellas se encuentran las restricciones de transferencia de información por USB, los mecanismos de autorización entre dispositivos y la validación de identidad durante los procesos de vinculación. En las pruebas documentadas, Claude identificó formas de superar esas protecciones, incluyendo una falla en la verificación de un código de seis dígitos y una ruta alternativa de transferencia de datos que permitió recuperar archivos.
El resultado fue particularmente significativo: una cadena de fallas que, combinadas, permitían obtener fotografías y otra información personal sin necesidad de desbloquear el teléfono. No se trató de una vulnerabilidad universal en todos los dispositivos Android, ni de un ataque remoto ejecutable indiscriminadamente desde internet. La demostración requería acceso físico al equipo y condiciones específicas. Precisamente por eso es importante describirla con rigor, sin aumentar artificialmente su alcance.
Lo verdaderamente relevante es que la inteligencia artificial participó en el descubrimiento y la integración de distintas debilidades hasta producir un resultado verificable. Estamos frente a sistemas capaces de recorrer arquitecturas complejas de software y encontrar relaciones entre fallas que individualmente podrían parecer insuficientes para comprometer un dispositivo.
La existencia de una actualización correctiva resuelve el problema específico identificado, pero el episodio deja una pregunta abierta sobre la velocidad con la que aparecerán nuevas vulnerabilidades y nuestra capacidad para descubrirlas, corregirlas y mantener protegidos los dispositivos que utilizamos todos los días.
El riesgo de entregar autonomía sin establecer límites
Hasta hace relativamente poco, la mayoría de nuestras interacciones con inteligencia artificial consistía en formular preguntas, generar documentos, analizar información o solicitar recomendaciones. Ahora comenzamos a utilizar agentes que pueden entrar a nuestros archivos, consultar correos electrónicos, gestionar calendarios, ejecutar instrucciones, interactuar con aplicaciones y comunicarse con sistemas externos.
Estas capacidades resultan extraordinariamente útiles en entornos profesionales. Un agente comercial puede investigar prospectos, preparar propuestas y mantener actualizada una base de datos. Otro puede examinar información de mercado, organizar documentos o apoyar decisiones operativas. El beneficio es evidente, pero cada nueva conexión también supone una autorización que debemos examinar.
Visualiza esto: Un agente dispone de acceso al correo electrónico, a determinados documentos y a una herramienta capaz de enviar información hacia el exterior. Durante una investigación encuentra una página web o recibe un documento que contiene instrucciones maliciosas diseñadas para alterar su comportamiento. Si el agente interpreta ese contenido como una orden y sus permisos son demasiado amplios, podría realizar una acción que su propietario nunca autorizó conscientemente.
Este tipo de ataque se conoce como inyección de instrucciones o prompt injection. Su peligrosidad aumenta cuando los modelos tienen capacidad para utilizar herramientas, acceder a información confidencial o modificar sistemas. OWASP, organización de referencia en seguridad de aplicaciones, recomienda limitar los privilegios de los agentes, aislar sus entornos de operación y mantener supervisión humana sobre las acciones de mayor impacto.
Mi preocupación: es perfectamente posible tener un equipo técnicamente actualizado y, al mismo tiempo, mantener una arquitectura de trabajo inadecuada para el nivel de autonomía que estamos concediendo a nuestros agentes. Esto es prueba y error y descarga de apps o software en un entorno 100% actualizado
Un dispositivo donde conviven cuentas bancarias, inversiones, fotografías familiares, gestores de contraseñas, archivos empresariales, llaves de criptomonedas y aplicaciones conectadas con IA puede representar una concentración innecesaria de información sensible. Esto no significa que los agentes puedan acceder automáticamente a todos esos recursos. Significa que, cuando concentramos demasiadas funciones y permisos en un mismo entorno, aumentamos las posibles consecuencias de una falla de seguridad.
Mi propuesta: separar nuestra vida privada del entorno donde trabaja la IA
Considero que ha llegado el momento de evaluar seriamente una práctica que hasta hace algunos años podía parecer excesiva para un usuario convencional: trabajar con dos dispositivos independientes, destinados a funciones distintas y organizados bajo criterios de seguridad claramente establecidos.
El primero estaría reservado para nuestra vida privada y patrimonial. Allí permanecerían las aplicaciones bancarias, las plataformas de inversión, la información financiera, los mecanismos de recuperación de cuentas, los gestores de credenciales, las llaves de acceso a criptomonedas y otros archivos personales especialmente sensibles. Este dispositivo no tendría agentes autónomos con acceso a su información y se utilizaría bajo una política mucho más restrictiva de instalación de aplicaciones, conexiones y permisos.
El segundo funcionaría como nuestro entorno profesional de inteligencia artificial. Sería el espacio destinado a experimentar con agentes, integrar herramientas, desarrollar automatizaciones, analizar información y ejecutar los procesos que requieren conectividad con distintos servicios. Sus permisos estarían limitados a los recursos necesarios para trabajar, sin incorporar información bancaria personal, respaldos privados o credenciales que no guarden relación con su función.
No considero que esta separación física constituya una garantía absoluta. Dos equipos pueden seguir compartiendo vulnerabilidades si utilizan las mismas cuentas, sincronizan archivos sensibles o mantienen sesiones y credenciales comunes. Por ello, la verdadera protección requiere complementar la separación de dispositivos con identidades digitales diferenciadas, controles de acceso, actualizaciones y reglas específicas para los agentes.
Tampoco sostengo que todas las personas deban comprar inmediatamente un segundo equipo. Existen alternativas, como entornos virtualizados, escritorios de trabajo aislados y sistemas administrados con permisos restringidos, aunque no todos ofrecen el mismo grado de separación. Mi planteamiento está especialmente dirigido a quienes utilizamos intensivamente la inteligencia artificial, incorporamos nuevas plataformas con frecuencia y estamos comenzando a delegar operaciones a agentes capaces de actuar por nosotros.
La productividad no debería obligarnos a concentrar toda nuestra identidad digital en el mismo lugar donde probamos herramientas, conectores o automatizaciones cuyo comportamiento y alcance todavía estamos aprendiendo a controlar.
Los siguientes pasos: convertir la precaución en una práctica
Antes de incorporar nuevos agentes a nuestro trabajo, considero necesario realizar un inventario de los accesos que ya hemos concedido. Muchas personas han autorizado aplicaciones para leer correos, consultar unidades de almacenamiento o acceder a servicios completos sin revisar posteriormente si esos permisos continúan siendo necesarios. La primera medida práctica consiste en identificar esas conexiones, revocar las que no se utilizan y restringir las restantes al mínimo indispensable.
El siguiente paso es establecer una clasificación de la información. No todos los documentos merecen el mismo nivel de protección. Un archivo comercial de consulta pública no representa el mismo riesgo que una base de datos de clientes, una declaración fiscal, una contraseña maestra o una llave privada de criptomonedas. Los agentes deberían trabajar exclusivamente con la información que necesitan y, siempre que sea posible, con copias preparadas específicamente para sus tareas, eliminando datos confidenciales que no aporten valor a la operación.
También resulta indispensable establecer mecanismos de aprobación humana. Un agente puede investigar, clasificar y preparar información sin que necesariamente deba tener autorización para ejecutar transferencias, eliminar documentos, modificar permisos o enviar comunicaciones sensibles. Las operaciones críticas requieren controles independientes del propio modelo, de manera que una instrucción maliciosa no pueda convertirse automáticamente en una acción irreversible.
A estas medidas agregaría la actualización constante de sistemas operativos, navegadores y aplicaciones, la autenticación multifactor, preferentemente resistente a la suplantación de identidad, y la utilización de credenciales diferentes para cada entorno. Las organizaciones deberían complementar estos controles con registros de actividad y auditorías periódicas que permitan identificar comportamientos inesperados de sus agentes.
Finalmente, propongo establecer una revisión de seguridad antes de conectar cualquier nueva herramienta de IA. Deberíamos conocer quién desarrolla el servicio, qué información procesa, dónde la almacena, qué permisos solicita, qué operaciones puede realizar y cómo es posible revocar su acceso. En entornos empresariales, esta revisión tendría que formar parte de las políticas de adopción tecnológica, en lugar de depender exclusivamente del criterio individual de cada colaborador.
La responsabilidad que no deberíamos delegar
Durante años hemos aprendido a proteger nuestros dispositivos frente a programas maliciosos, enlaces fraudulentos y accesos no autorizados. La llegada de los agentes inteligentes agrega una dimensión distinta: ahora también debemos administrar cuidadosamente las autorizaciones que concedemos a sistemas diseñados para actuar en nuestro nombre.
El episodio del Android bloqueado representa una evidencia de hasta dónde pueden avanzar las capacidades de investigación asistida por inteligencia artificial. La misma tecnología que permitió construir una cadena de explotación también hizo posible descubrir una debilidad y contribuir a su corrección antes de que se conociera públicamente el método. Esa capacidad defensiva merece reconocimiento, porque ofrece oportunidades importantes para fortalecer la seguridad de los sistemas que utilizamos.
Sin embargo, los beneficios de la IA no justifican conceder acceso indiscriminado a nuestra información. Estoy convencido de que necesitamos aprender a trabajar con distintos niveles de confianza y adoptar una disciplina de protección digital acorde con la autonomía que estamos entregando a nuestras herramientas.
Mi propuesta de utilizar dos dispositivos independientes nace de esa convicción. Quiero aprovechar todas las posibilidades de la inteligencia artificial para investigar, producir, automatizar y ampliar mis capacidades profesionales, pero no encuentro razones suficientes para exponer innecesariamente mi vida financiera, mi patrimonio digital o mi información más personal dentro del mismo entorno donde operan agentes y aplicaciones externas.
La seguridad absoluta no existe y ningún dispositivo permanece invulnerable para siempre. Lo que sí podemos hacer es reducir las oportunidades de acceso, limitar el alcance de una posible intrusión y conservar bajo nuestro control las decisiones que comprometen nuestra privacidad.
Los fabricantes seguirán corrigiendo vulnerabilidades, los investigadores seguirán descubriéndolas y la inteligencia artificial participará cada vez más en ambos procesos. Mientras eso ocurre, nosotros debemos decidir cómo organizamos nuestra vida digital.
La confianza que depositamos en la inteligencia artificial debería crecer al mismo ritmo que nuestra capacidad para establecerle límites.
Y desde esa perspectiva, considero que separar el dispositivo de nuestra vida privada del entorno donde operamos con inteligencia artificial ya merece formar parte de una conversación seria sobre ciberseguridad, tanto personal como empresarial.
Bonus: Cronología de 2026: de las instrucciones maliciosas a algunas vulnerabilidades críticas
El caso de Android adquiere mayor relevancia cuando se coloca junto a otros acontecimientos documentados durante 2026. No estamos ante cinco ataques relacionados entre sí ni ante una campaña coordinada de ciberdelincuencia, sino frente a investigaciones independientes que permiten observar cómo están cambiando las capacidades de análisis y los riesgos de seguridad asociados con la inteligencia artificial.
El 7 de mayo de 2026, Microsoft publicó una investigación sobre dos vulnerabilidades críticas en Semantic Kernel, un entorno utilizado para construir agentes de IA. Los investigadores demostraron que, bajo determinadas condiciones, instrucciones manipuladas podían conducir a la ejecución de código no autorizado o permitir que un agente escribiera archivos fuera de los límites previstos. Las fallas, identificadas como CVE-2026-26030 y CVE-2026-25592, fueron corregidas, pero dejaron expuesto un problema especialmente delicado: cuando una IA dispone de herramientas capaces de ejecutar acciones, una instrucción maliciosa puede dejar de ser simplemente texto para convertirse en una operación dentro de un sistema informático.
El 21 de octubre de 2026, OpenAI informó sobre una investigación coordinada para corregir vulnerabilidades críticas en PHP, uno de los lenguajes de programación ampliamente utilizados en aplicaciones y servidores web. Su iniciativa Patch the Planet involucró a mantenedores de PHP, investigadores y empresas de seguridad. Una de las fallas fue identificada mediante GPT-5.6 Sol, mientras que Wiz descubrió y reportó de forma independiente las vulnerabilidades. La gravedad de los hallazgos radicaba en la posibilidad de comprometer servidores vulnerables sin disponer previamente de credenciales válidas.
El 27 de octubre, Anthropic hizo públicos los resultados de su investigación con Claude. Además del caso Android, presentó cadenas de explotación contra Google Chrome, Safari y el núcleo de Linux. En Chrome, el modelo consiguió desarrollar una secuencia capaz de escapar de los mecanismos de aislamiento del navegador y ejecutar código en el equipo. En Safari demostró cómo vulnerar restricciones diseñadas para impedir que un sitio web acceda a información de otros sitios, con posibles consecuencias para las sesiones de correo electrónico o servicios financieros. En Linux identificó una vulnerabilidad que, bajo configuraciones específicas, podía permitir la ejecución remota de instrucciones con privilegios de administrador.
Los hallazgos se comunicaron a los fabricantes y responsables correspondientes para facilitar las correcciones antes de divulgar los detalles técnicos. Esta precisión resulta indispensable para entender el fenómeno: buena parte de los descubrimientos más preocupantes de este año procede de investigaciones defensivas cuyo propósito es mejorar la seguridad del software, no de ataques criminales confirmados.
La cronología permite reconocer algo más profundo. La IA está aumentando las capacidades disponibles para investigar vulnerabilidades, mientras que los agentes autónomos introducen nuevas superficies de exposición dentro de nuestros propios entornos digitales. Son dos fenómenos distintos, pero su convergencia obliga a revisar las decisiones de seguridad que considerábamos suficientes.
Fuentes de referencia
– [Anthropic — Discovering and Exploiting Vulnerabilities in Critical, Real-World Software with Claude (27 de octubre de 2026)](https://www.anthropic.com/research/discovering-vulnerabilities-with-claude)
– [OpenAI — Patch the Planet: respuesta global a vulnerabilidades críticas detectadas por agentes (21 de octubre de 2026)](https://openai.com/es-419/index/coordinated-disclosure-of-critical-vulnerabilities/)
– [Microsoft Security — When Prompts Become Shells: RCE Vulnerabilities in AI Agent Frameworks (7 de mayo de 2026)](https://www.microsoft.com/en-us/security/blog/2026/05/07/prompts-become-shells-rce-vulnerabilities-ai-agent-frameworks/)
– [OWASP — AI Agent Security Cheat Sheet](https://cheatsheetseries.owasp.org/cheatsheets/AI_Agent_Security_Cheat_Sheet.html)